
A Qwen 27B modell történetét vizsgálva felmerül a kérdés, hogy egy nyílt forráskódú, kínai fejlesztésű mesterséges intelligenciát hogyan formálhat tovább egy másik csapat – jelen esetben a Nous Research. Az Arete-27B ugyanis ennek a Qwen-modellnek egy sajátos továbbképzése, új értékrendekkel való finomhangolása mentén készült.
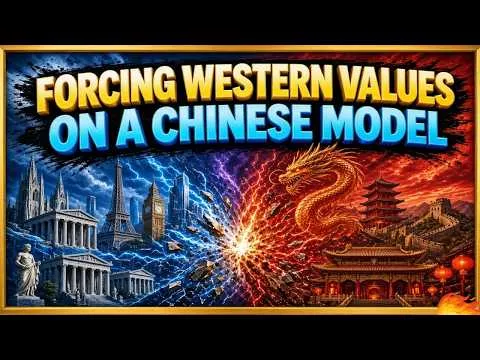
Érdemes elgondolkodni azon, hogy a mesterséges intelligenciák mindig magukban hordozzák fejlesztőik szempontjait, döntéseit, értékrendjét. Mennyiben írható le egy MI modell „értéksemlegesnek”, ha arra hatással van a forrásország társadalmi és politikai környezete? Maga az Arete-27B kísérlet például kifejezetten nyugati értékeket épített be a kínai modellt továbbtrenírozva.
A videó technikai részletekbe is betekintést ad: milyen tréningmódszerekkel dolgozott a Nous Research, mely témakörökben generáltak új promptokat (pl.: szólásszabadság, állami ideológia, adatvédelem, demokrácia), és hogy milyen eredményeket mértek a változtatások után. Megemlíti a mérési eltéréseket, valamint felveti azt a kérdést, hogy mennyire tekinthető objektívnek az ilyen, saját értékrend szerint végzett „propaganda-értékelés”.
Külön érdekesség, hogy csak a nyílt súlyú – szabadon letölthető és módosítható – MI modellek teszik lehetővé az efféle átalakításokat. A zárt modelleknél (mint Claude vagy GPT) ez technikailag nem kivitelezhető. Ez felveti a transzparencia, nyitottság, sőt, a szabályozhatóság kérdését is az MI világában.
Mindemellett a bemutatott esettanulmány újabb gondolatokat ébreszt az MI-kultúra, értékpluralizmus, illetve a fejlesztői felelősség témaköreiben, miközben objektíven próbál rámutatni a kulturális és politikai különbségek szerepére az MI modellek formálásában.