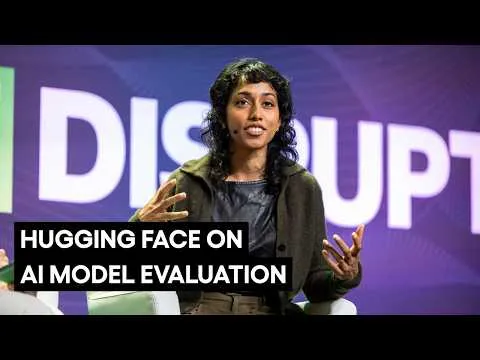

Az interjú során a mesterséges intelligencia modellek értékelésének aktuális kérdéseit vizsgálják, különös tekintettel arra, hogyan változott az értékelési gyakorlat az elmúlt tizenkét hónapban. Kiemelt figyelmet kap az értékelések reprodukálhatósága, megbízhatósága, és az, hogy miként alakítják a nagyobb erőforrásokkal rendelkező laboratóriumok az iparágat.
Részletesen szóba kerülnek az erőforrások közötti egyenlőtlenségek, valamint az, hogy a kisebb szereplők hogyan tudnak lépést tartani a gyorsan fejlődő értékelési módszerekkel és benchmarkokkal. Az értékelési kártyák és a közösségi platformok hozzájárulása új sztenderdek kialakításához szintén a fókuszba kerül.
Felmerül a kérdés, hogy az MI modellek és ügynökök fejlesztésének mely aspektusait kell kiemelten mérni a bevezetés előtt – legyen szó kiadás előtti, biztonsági vagy konkrét termékbevezetési értékelésről. Arról is szó esik, hogy a modell vagy az egész rendszer környezete (például harness, adat, telepítés) adja-e a legnagyobb hozzáadott értéket az alkalmazás során.
Egy jelentős pontot jelent a transzparencia kérdése, különös tekintettel a társadalmi és környezeti hatások mérésére, illetve a modell-szolgáltatók által közölt adatok elégtelenségére. A kormányzat szerepe, valamint az állami és közösségi finanszírozás lehetőségei szintén vitatéma.
További témák között szerepel a benchmark-szaturáció, a jó értékelési módszerek hiánya miatti potenciális szűk keresztmetszetek, illetve hogy a közösségi értékelések hogyan segíthetik a startupokat a megfelelő döntések meghozatalában.