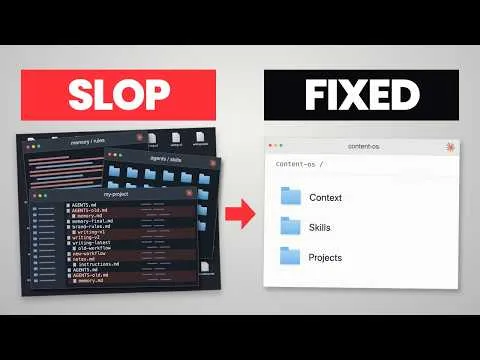

Az otthoni vagy vállalati számítógépeken gyakran gyűlnek össze évek alatt elmentett munkafájlok, szerződések, vázlatok és dokumentumok. Amikor mesterséges intelligenciát (AI-t) kapcsolunk ezekhez az adatokhoz, egy komoly probléma merül fel: az AI minden fájlt egyformán megbízhatónak tekint, nem tud különbséget tenni a régi, elavult adatok és a legfrissebb, aktuális információk között. Ez téves idézeteket, elavult adatok felhasználását és félrevezető válaszokat eredményezhet bármilyen keresésnél vagy elemzésnél.
Felmerül a kérdés: miként alakíthatunk ki egy „vállalati agyat”, amelyben az AI minden választ pontos forrásmegjelöléssel, hibák és adathalmozás nélkül szolgáltat? Az előadó gyakorlati tapasztalatai szerint a probléma nem egy okosabb AI-val, hanem a munkaanyagok strukturálásával és tisztításával oldható meg. A folyamat során kiemelten fontos az adatok megszűrése, a duplikált vagy elavult fájlok archiválása, illetve az, hogy az AI ne változtathassa vagy törölhesse az eredeti fájlokat engedély nélkül.
A videó lépésről lépésre bemutatja azt az eljárást, amelyben először megszűkítjük az AI által áttekintendő fájlokat, majd instrukciós és összefoglaló fájlokat hozunk létre. A rendszer háromlépcsős adatfeltárást alkalmaz: tartalomjegyzék, összefoglalók és csak végszükség esetén a nyers dokumentumok elemzése. A bemutatott módszertan hangsúlyozza a logolást, a folyamatos naprakészen tartást és az objektív kérdésekkel végzett rendszeres tesztelést is – mindez a megbízható, átlátható információ-visszakeresés érdekében.
A gyakorlati példákat esettanulmányok, alapvető prompt-sablonok és kézzelfogható munkafolyamat-lépések gazdagítják. A néző megtudhatja, hogyan lehet minimális technikai tudással, már meglévő eszközökkel kialakítani saját „tiszta vállalati agyat”, amellyel hatékonyabbá és biztonságosabbá tehető a mesterséges intelligencia alkalmazása a mindennapi munka során.