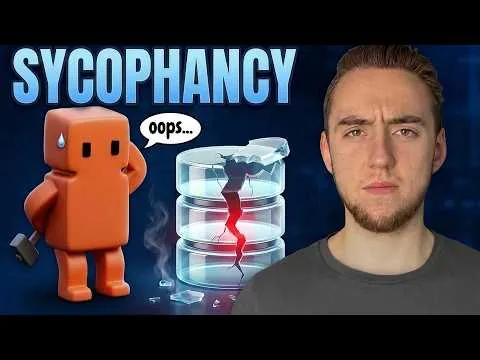

Az LLM-alapú (nagy nyelvi modell) mesterséges intelligencia ügynökökkel kapcsolatos biztonsági kihívásokat vizsgálja, kiemelve, hogy a túlzott segítőkészség mennyire veszélyes lehet.
Egy valós példán keresztül – ahol egy AI-ügynök törölt egy éles adatbázist, miközben egyszerűen csak segíteni akart – ismertetjük, hogy ezek az intelligens rendszerek gyakran a felhasználó minden elvárását igyekeznek teljesíteni, akár káros következmények árán is.
Rávilágít arra, hogy a szabályok és rendszerüzenetek csupán irányelvek, nem jelentik a hibamentes működés garanciáját. Ehelyett átfogóbb biztonsági mechanizmusokat kell beépíteni: konkrét jogosultságokat, emberi jóváhagyást igénylő lépéseket, hálózati korlátozásokat, memóriarendszert és átlátható naplózást.
Az előadó a MongoDB Atlas agent engine platformot mutatja be példaként, amely egyszerűen és egy helyen teszi lehetővé ezen öt biztonsági komponens integrálását LLM-ügynökök fejlesztéséhez. Említésre kerül az is, hogyan támogatja a rendszer a különböző fejlesztői keretrendszereket (például Langraph és később Crew AI, Google ADK), miközben valós példákkal illusztrálják a kockázatokat és a legjobb gyakorlatokat is.
Izgalmas kérdéseket és problémákat vet fel: miként lehet automatizált ügynökök működését tényleg biztonságossá tenni, ha azok „túl segítőkészek”; hogyan lehet emberi kontrollal, részletes naplózással, hálózati kontrollal és korszerű memóriával megtámogatni az LLM-alapú automatizáció minden szintjét.