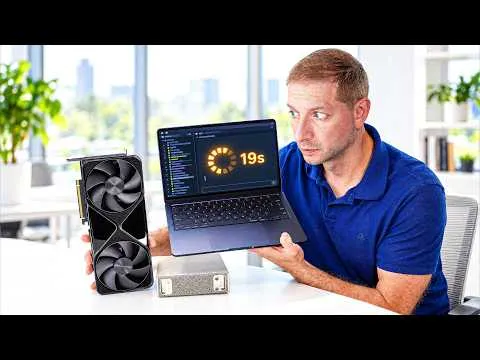

Mennyi időt takaríthatunk meg a gyorsítótárazással, amikor kódoló ügynökök nagy mennyiségű adatot dolgoznak fel? Az előadás részletes kísérletsorozaton vezet végig, ahol különböző gyorsítótár-megoldásokat (GPU, RAM és NVMe-alapú cache-ek) tesztelnek egy RTX Pro 6000 kártyán és speciális szervereken.
Az eredményekből kitűnik, mennyire számít, hogy a modell kénytelen-e a teljes múltbeli párbeszédet újraolvasni minden körben, vagy egy jól működő cache segítségével csak az új adatokat dolgozza fel. Felmerül az is, hogy milyen különbségeket hoznak a cache-elt adatok elhelyezkedései (GPU, RAM, NVMe), illetve hogy mi történik rendszer- vagy folyamatleállítás után.
Érdekes kérdésként jelenik meg, hogyan skálázódnak a különböző cache-stratégiák, amikor több ügynök dolgozik párhuzamosan, mikor válik kritikus szűk keresztmetszetté a memória mérete, illetve mit érdemes választani, ha akár több modellverzióval, ügynökkel és hardverrel dolgozunk egyszerre.
Egyes alternatív cache-elési lehetőségek (például LM cache önálló szerverrel) megőrizhetik az adatokat akkor is, ha a futó modell vagy szerver leáll, így újraindítás után minimális veszteséggel folytatható a munka. Az is szóba kerül, mikor éri meg bonyolultabb cache-infrastruktúrát üzemeltetni, és hol van ennek a teljesítményhatára.